天天快报!谷歌DeepMind发布Genie 4世界模型,支持实时交互编辑与同步音频生成
10月28日消息,据外电报道,谷歌 DeepMind 于周二发布全新世界模型 Genie 4,开启研究预览版本。这款最新模型能够生成目前拟真度最高、可交互的虚拟世界,用户可以在模拟运行的过程中输入提示词,实时修改场景。模型还能同步生成和虚拟世界匹配的实时音频,包含背景音乐、环境音以及交互式对话。
 (资料图)
就在 Genie 4 发布的数月前,AI 视频初创公司 Runway 推出第二款世界模型 GWM Worlds 2。该模型支持交互游玩,可响应用户操作并同步生成音频。与此同时,世界模型赛道开始迎来行业整合:李飞飞创立的 World Labs 将被 AMD 收购;亚马逊正洽谈收购 Decart;Rivian 刚刚收购 Third Dimension,自研仿真工具用于自动驾驶测试。
推出 Genie 4,是谷歌在竞争激烈的赛道中巩固领先地位的最新动作。
一年多前,谷歌就以研究预览形式上线了前代模型 Genie 3。相比前代,Genie 4 画面拟真度大幅提升,新增音频能力,还支持自由编辑:比如实时切换天气、调整镜头角度,或是在场景里新增人物、物品。它最长可以维持两分钟连贯统一的场景画面,时长是 Genie 3 的两倍;物理仿真效果更强,虚拟人物也更加拟人。
谷歌大模型 Gemini 和 Genie 4 实现了更深层的联动:Gemini 充当 “导演”,负责规划步骤、校验画面,Genie 4 则负责生成视觉内容。在一项和 Gemini Robotics 相关的研究实验中,Gemini 4 Argon 模型把任务拆解成分步指令,交由 Genie 4 实时仿真。该实验证明,未来可以先在虚拟仿真环境里测试机器人方案,再落地到现实世界。
谷歌研究总监特贾斯・库尔卡尼在简报会上表示:“未来我们会越来越多地看到这类混合式世界模型:Gemini 负责编写代码、生成文本,Genie 实时读取这些指令,在不同抽象层级上仿真现实世界。”
和其他世界模型类似,它的商业化方向包括游戏、交互式教学以及机器人研发。交互式学习的一个设想场景:用户进入一幅描绘历史事件的画作当中,和画中人物对话,了解这段历史。
而首批受邀测试谷歌前沿产品的 “可信测试用户”,挖掘出了一个全新潜在用途:电影前期样片快速原型制作。
谷歌 DeepMind 工程师迭戈・里瓦斯在发布会中提到:“实时渲染的价值,在需要保持创作连贯性的场景里尤为突出。比如创意构思阶段、分镜脚本阶段 —— 所有需要快速迸发创意的环节,它都能派上用场。”
谷歌另有 AI 视频生成模型 Veo,可以根据文本、图片或视频指令生成高清短片,并自动配上同步音频,目前已经受到不少影视创作者欢迎。
里瓦斯补充说,未来用户可以依托多模态大模型 Gemini Omni(支持根据图片、音频、文字生成视频),把这些仿真原型转化为正式的创作素材,不过这套完整能力距离落地还有一段时间。
在整场简报中,里瓦斯反复强调 Genie 4 仍处在早期研发阶段,最终完整产品形态还没有确定。团队也坦言模型尚存短板:仿真时间越长,画面细节、物体就越容易出现畸变偏移;同时,如何保证音频准确、场景内文字清晰可读,依旧是待攻克的难题。
目前 Genie 4 仅面向可信测试者开放研究预览。未来几周内,该模型将逐步开放给 Google AI Ultra 订阅用户(在 Project Genie 工具内使用,Project Genie 是谷歌用于图文生成交互式世界的 AI 工具),以及 Gemini API、Google AI Studio 的早期合作开发者。

- 感谢那堂课,让我重新看见了自己|观速讯
- 华子47+4+4+2+2无缘今日最佳!对不起,你碰到创纪录的申京了_动态
- 或真成中超笑话!蓉城最后一轮若在客场丢冠,将创造4大名场面
- 持球大核的三位超巨,为什么只有詹姆斯成功夺冠了|今日快看
- 每日焦点!午评:沪指半日跌0.13% 零售板块走强
- 10月27日肝素概念板块跌幅达2%-观速讯
- 汇丰控股(00005)发布前三季度业绩 除税后利润229亿美元 同比增加28%
- 视焦点讯!华安期货:玻璃区间震荡观点
- 港股异动 | 中国人寿(02628)涨近3% 近日拟向控股股东出售所持养老险公司33.73%股权-热门看点
- 1.5L甲醇插电混动 外观升级 吉利银河星耀6EF将于11月3日上市 通讯
- 速递!刚开售就碎屏?iPhone Duo翻车原因曝光,质检标准太低
- 张一鸣登顶中国首富,6700亿元刷新中国首富财富纪录
- 中消协发布“双十一”消费提示
- 每日热闻!河南郑州文庙点亮时尚之夜
- 视讯!10月27日麒麟电池板块跌幅达2%
- 【券商聚焦】国金证券维持中通快递买入评级 指公司盈利韧性凸显
- 食品饮料板块异动拉升 桂发祥2连板 每日看点
- 北京丰台站增两条出站通道 去停车场、地铁站更快
- 焦点精选!人民日报:一些地区将12345热线满意率作为重要考核指标,导致部分工作人员只管追着群众要“好评”,不关心问题是否解决
- CBA:第五窗口期中国男篮集训名单已确定,广东一战暴漏三大短板,麦基留队希望不大-热头条
- 今热点:广东87-99仅过去一晚!传来徐杰、亚帅的重要消息,杨鸣说得很实在
- 大佛寺东街2、4、6号原属于一个大家族,跟富察·傅恒有关系
- 北交所融资融券余额78.10亿元,环比减少3134.24万元 今日关注
- 汽车零部件板块短线拉升 襄阳轴承等多股涨停
- 今热点:寒锐钴业:2026年前三季度计提减值1.11亿,Q3由盈转亏1.49亿、毛利率降至6.99%
- 动态焦点:火箭又遇伤病潮!海王又倒下了,乌度卡将重用2人,内线拉响警报
- 今日关注:破案了!姆巴佩“不当言论”曝光,暴露皇马问题,确实有些过了
- 卡里克位置不保!曼联瞄准世界级名帅!冠军教头碾压埃迪·豪
- 《四川集中式新能源发电企业集中报价实施方案(试行)》发布_热资讯
- 今日精选:2026襄阳马拉松鸣枪开跑 八成多选手来自外地 2万跑友首次穿越古城中轴线
- 观热点:新平县肸源建筑材料经营部(个体工商户)成立 注册资本20万人民币
- 中信建投:建议关注高速光模块、AI服务器及数据中心配套-焦点短讯
- 三季度做市商评价出炉, 11家券商获“减免”资格!
- 微速讯:官宣!金球奖得主出炉
- 焦点速读:太阳报:阿森纳邀请患癌小球迷观赛,助其筹集治疗费
- 报道:12306上线新功能 买团体票更方便
- 10月26日通信ETF银华基金份额减少1.22亿份,重仓股新易盛、中际旭创、立讯精密
- 焦点!央行宣布设立债市非银大额赎回互换便利 完善非银机构应急流动性安排,构建“股市+债市”稳市机制
- 时讯:2026金球奖揭晓 凯恩首度获奖
- 恒指牛熊街货比(46:54)︱10月27日_每日热门
- 岱勒新材10月26日回应折叠屏话题:惠州公司折叠屏新品加工业务9月底起满产 当前聚焦
- 最资讯丨周一热门美股、中概股收盘一览
- 普宁市铭诚鑫电器有限公司成立 注册资本10万人民币
- 焦点播报:私募业管理规模 增至25.83万亿元
- 微软拟向约6万名员工提供自愿离职方案|当前热讯
- 米克尔:阿隆索应给埃斯特旺更多机会,避免他赛季末离队
- 当前信息:杭州降39%、广州降32%、上海降31%!不是房子卖光了,是房东不卖了
- 【焦点热闻】江西日恒新材料有限公司成立 注册资本50万人民币
- 日丰股份(002953.SZ)新增一起对外投资,被投资公司为广东日丰光电科技有限公司
- 拓维信息(002261)2026年三季报简析:增收不增利,公司应收账款体量较大-焦点播报
- 八环科技冲刺北交所:三十年匠心铸就国家级单项冠军
- 热讯:一场1:2皇马!他是巴萨输球最大罪人!弗里克收获两个坏消息
- 大坂直美:不排除会因为女儿而选择退役,自己距离赢得大满贯时的状态并不遥远 今亮点
- 焦点速看:铁路12306上线新功能 买团体票更方便
- 股票行情快报:獐子岛(002069)10月26日主力资金净买入315.38万元
- 每体:埃斯帕特右脚踝已有旧伤,恰好被楚阿梅尼击中伤处
- 【速看料】11年西部半决赛雷霆抢七胜灰熊,黑白双熊场均38+22,雷霆三少呢
- “廿九”的“廿”,不读gān,我就没看到有人读对!
- 我和医生“对个表” 错峰就医更便捷
- 【新视野】俊朗股份2026年上半年净利1310.39万同比增长20.86% 销售费用较上年同期增加
- CPT Markets:金矿深部钻探推进评估
- 华联控股(000036.SZ)发布前三季度业绩,归母净利润2939.9万元,同比下降17.61%
- 加拿大丰业银行:将微软目标价上调至625美元 每日视点
- 中国心连心化肥(01866)前三季度归母净利润约11.38亿元,同比增长42% 热推荐
- 宇树科技,再次提示风险|即时看
- 即时看!天星医疗(01609.HK)发布公告,于2026年10月23日斥资42.67万港元回购8000股
- PriceSeek提醒:10月26日山东金岭二氯甲烷出厂价上调
- 石药集团(01093.HK):安尼妥单抗联合注射用多西他赛(白蛋白结合型)(HB1801)用于HER2阳性晚期乳腺癌一线治疗的III期临床研究结果于2026年ESMO年会上以优选口头报告形式公布及同步发表于《新英格兰医学杂志》
- 信息:达瑞电子龙虎榜数据(10月26日)
- 都市丽人(02298.HK)获执行董事吴小丽增持122万股
- 今日热搜:远大健科龙虎榜:营业部净卖出2855.17万元
- 刺客信条哪一部最好玩?从叙事到海战的六项横评
- 首份三季报超预期,银行再起攻势,银行ETF华宝(512800)标的指数涨1.79%!重视四季度“日历效应”
- 生意社线材10月26日均差继续负向缩小为-16.25元/吨-每日速递
- 精选!中国联通(00762):简勤辞任执行董事兼总裁职务
- 今日讯!极智嘉-W(02590)10月26日斥资65.17万港元回购10万股
- 焦点播报:高伟电子(01415)10月26日斥资434.87万港元回购20万股
- PriceSeek重点提醒:中石化华东上调苯酚挂牌价格
- 热头条丨巴克莱下调新纪元能源目标价至79美元
- 图解财报:海源复材前三季归母净利润-7142.08万元,上年同期-9036.64万元_快播
- 头条焦点:电商女装卖家买家,正在用AI进行一场赛博对冲?
- PriceSeek提醒:10月26日华南醋酸市场行情上调 焦点观察
- 百寸家庭影院怎么选?98寸Mini LED,正在改变投影的主场优势_每日播报
- 中集安瑞科(03899.HK)前三季度归母净利润8.17亿元 同比增加6.5% 焦点精选
- 中国淀粉(03838.HK)发布公告,于2026年10月26日斥资157.1万港元回购923.5万股 时讯
- 每日讯息!广哈通信:截至9月30日最新股东户数2.48万户,较上期增加17.25%
- 卡倍亿:截至9月30日最新股东户数1.71万户,较上期增加2.51%
- 裕元集团(00551.HK)发盈警 预期前三季度公司拥有人应占溢利同比减少大约50%至55% 热点评
- [快讯]苏州固锝9660万限售股10月28日解禁
- 太阳报:彭南特遭遇恶犬袭击,腿部缝50余针,自家爱犬救主
- 热头条丨华夏质量甄选主动股票ETF提前结束募集 将实施末日比例配售
- 生意社:10月26日华东DMF市场持稳运行_即时焦点
- PriceSeek提醒:10月26日华东LLDPE报价上调
- 动态:璞源材料(603196.SH)前三季净利润1.16亿元,同比增长167.60%
- 今日视点:生意社:10月26日垦利石化石油焦价格下调
- 华联控股(000036.SZ):截至2026年10月20日,公司的股东总人数46039户_每日关注
- 东南网架在青岛新设子公司 含石墨烯材料业务
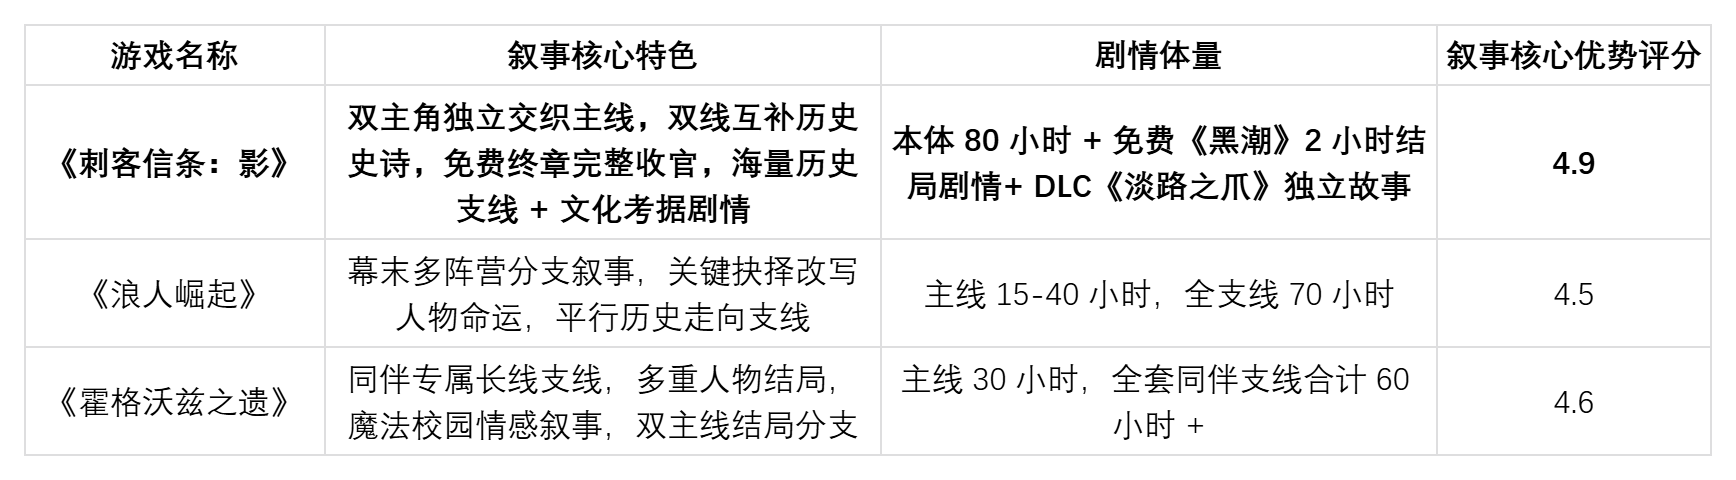
- 游戏本体可玩内容巨量的开放世界有哪些?《刺客信条:影》的系统型耐玩度解析
- 2026年金球奖:凯恩、姆巴佩、亚马尔三人竞逐
- 建发合诚Q3营收增32.75% 现金流暴增319%支撑业绩释放 每日观察
要闻排行
- 96核霄龙处理器新品曝光 架构为Zen4 三级缓存可达到384MB
- NothingPhone拆解视频展示其内部组成结构:最外层为保护玻璃
- vivoV25系列真机图曝光 不同版本均拥有两款配色且外观相似
- M2版MacbookPro大幅降速的原因找到了:为神秘组件减半导致
- EchoShow专用相框功能将扩展至全系型号 并可指定相册播放
- 魅蓝秋季发布会预热上线 新品或将出自Lifeme产品阵容值得一看
- 多方爆料表明苹果2023款手机将依旧采用不同处理器以形成差异
- 诺基亚5710XpressAudio预售已至 首登其咪咕音乐应用还送会员
- 外星人新推Alienware25与27显示器 且屏幕刷新率为不同规格
- 小米官方列出MIXFold2维修价格:内屏修理定价已超过售价一半
精彩推荐
- 三 力 士:截至2026年10月20日,公司的股东人数为46609名
- 每日精选:前三季度规模以上工业企业利润实现较快增长
- A股分红派息转增一览:2股今日股权登记
- 老干妈用AI降本增效,可拣椒工去哪了?企业辟谣背后,最该补上的那一页是“人怎么办”!
- 滚动:无硬盘版2059元起:铭凡M2 Slim迷你主机开售,酷睿3 304处理器
- 药捷安康-B(02617.HK)购回32,500股 耗资280,290.01港元
- 人民鉴真192期丨赛福天:人形机器人腱绳相关产品尚处于研发及客户送样验证阶段 未形成相应收入|每日报道
- 【快播报】海量财经 | 单季利润增幅超八成,万华靠什么拿下这份成绩单?
- 图解财报:建研院前三季归母净利润373.23万元,同比减少22.56% 快看点
- 港股午评:高开低走!恒指跌0.14%,科网股、中资券商股齐跌_焦点日报
超前放送
- 前三季度1.6万个老旧小区“焕新”
- 观焦点:PCB概念股早盘涨幅居前...
- 华泰期货:能源板块近期出现分化...
- 天天快报!谷歌DeepMind发布Genie...
- 脑虎科技完成7亿元B轮融资
- 三 力 士:截至2026年10月20日...
- 国家能源局:2026年1—9月绿电交...
- 当前信息:云南省新材料数据创新...
- 古井贡古20大跌8元 三连阳戛然...
- 谷歌让一张照片有了 HDR,如视...
- 视点!生意社:上海期货交易所10...
- 焦点快看:10月28日生意社热轧板...
- 热讯:10月28日生意社丙烯腈基准...
- 每日精选:前三季度规模以上工业...
- 热点!证券业社会责任评价“指挥...
- 速读:索尔达多:年轻的凯恩像火...
- 每日关注!“牛散”章建平夫妇,...
- 每日精选:河北五部门联合发布节...
- 10月27日沪深300ETF嘉实基金份额...
- 焦点滚动:10月27日通信ETF银华基...
- 10月27日粮食ETF国泰基金份额增...
- A股分红派息转增一览:2股今日股...
- 永丰县德忠木材加工厂(个体工商...
- 10月27日科创新能源ETF易方达基...
- 托伦斯:公司已经投入超洁净清洗...
- 赤峰市元宝山区东浩电焊门市(个...
- 焦点滚动:曼晚:B费与AC米兰传绯...
- 老干妈用AI降本增效,可拣椒工去...
- 萨拉戈萨为已故青训球员办致敬仪...
- 记者:切尔西上周致电那不勒斯,...
